
-
新版SPC的PPK.G CPK.G公式很简单吗?
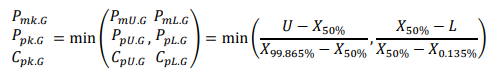
上面的是新版SPC的PPK.G CPK.G的计算公式,熟悉数学的人一眼就看出来如何计算的,很简单:
- 分子:就是规格上下限和中位数的距离
- 分母:就是99.865%、0.135%分位数和中位数的距离
这种算法称之为“经验分位”算法
很简单吧
但是,但是...
如果我们的spc分析报告上的数据点只有25点(如果是单值就是25个检测结果,如果子组=5,就有5*25=125个检测结果),这样:
 和
 都是非常靠近分布两端的极端分位数。
在样本的前后端,连一个完整的数据都没有。
即使通过样本分位数算法进行插值,得到的结果也几乎完全由最小值和最大值决定,不能可靠地反映总体分布的两端。
所以,小样本的问题不仅是“插值偏差较大”,而是样本中根本没有足够的尾部数据,无法直接、可靠地估计
 和
 这两个极端分位数。
那么手册中是如何解决这个问题的呢?
1、如果数据点数大于2000点,可以直接使用上述公式计算(经验分位)
2、如果数据点数小于2000点,比如25点,就需要拟合分布,从拟合分布中计算分位数来确定PPK.G、CPK.G,不能依靠实际数据估计两个极端分位数( 拟合分布)
先根据样本数据拟合合适的概率分布,例如:
- 正态分布;
- 对数正态分布;
- Weibull分布;
- Gamma分布;
- 其他适合该过程数据的分布。
确定拟合分布及其参数以后,再从拟合得到的理论分布中计算:


最后代入通用公式,计算PPK.G、CPK.G。
如何拟合分布?
这个就有点复杂了,简单一点的流程就是:
样本数据 → 候选分布 → 参数估计 → 拟合优度评价 → 确定分布 → 反累积分布函数计算分位数
根据样本数据,尝试拟合正态、对数正态、Weibull、Gamma等多种候选分布,并采用最大似然法估计各分布的参数。
然后结合拟合优度检验、概率图及AIC等指标,选择与数据最吻合且符合过程特征的分布。
确定分布后,通过其反累积分布函数计算


 ,再代入通用公式计算Ppk;如果过程稳定,同一结果也可以称为Cpk。
- 所有大样本(大于2000点)的PPK.G、CPK.G的计算确实非常简单,
- 但小样本(小于2000点)计算就非常复杂了,最好的方法是采用斌果SPC这类专业的、匹配最新版本SPC的专业SPC软件来计算。
本页面文章与公众号同步。
微信扫码关注